


同一个客户,核心系统里叫“客户号”,信贷系统里是“借款人编号”,报表系统又成了“客户编码”。人看得懂,智能体不一定:字段按哪条标准算,系统里没写清楚。
这两年监管的查法变了:一表通进入试行,同一笔业务在不同报送出口必须一致,差异得说清根因;不少字段从代码改成文本,靠通用码值字典批量映射已不够。问到某个字段按哪条标准取数、谁定的,行里还得翻表、找熟悉这块的人。表能报出去,出处说不清。
这类情况,普元在二十余年深耕金融领域、为200多家银行提供可依赖的产品、技术与服务的过程中见过很多。各家断的位置不同,卡住的是同一处:标准不贴本行的业务说法,字段又读不出业务含义,中间缺一层能把两边对上、把结果记下来、让签字的人放心的账。
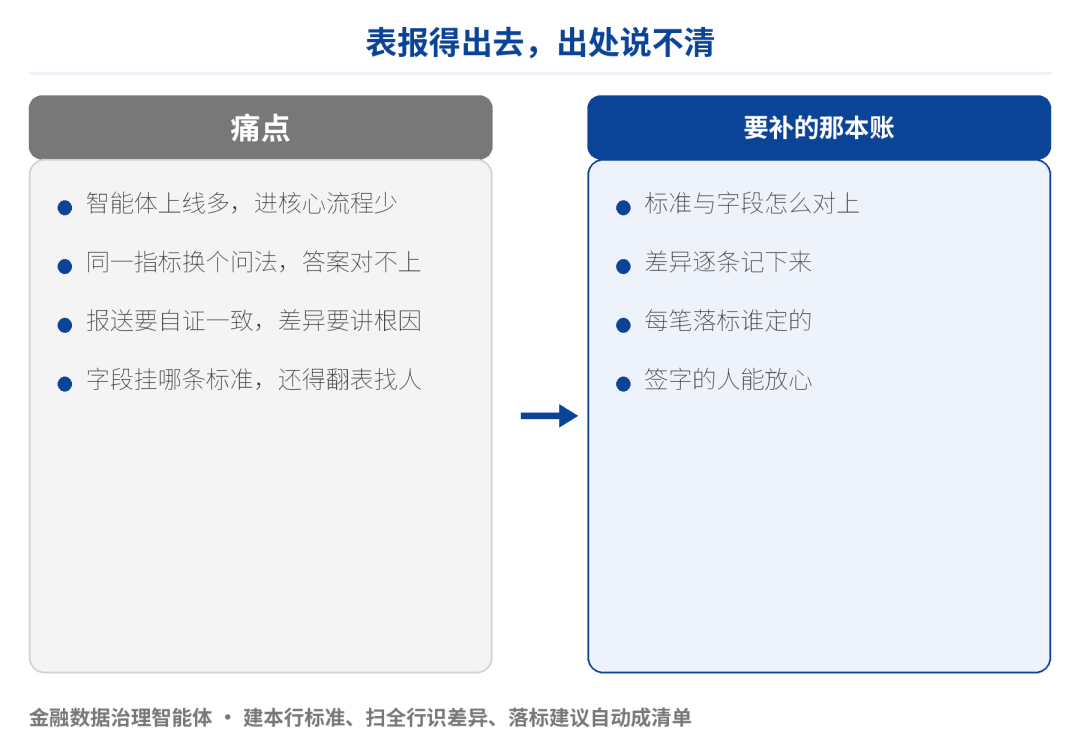
图1 表报得出去,出处说不清
国家政策和大模型,都追到这本账
放在过去,口径对不上只是标准岗自己的麻烦。这两年人工智能(885728)进了核心业务,从国务院“人工智能(885728)+”行动意见到“十五五”规划纲要,数据治理被写进国家部署。2026年6月,国家金融监督管理总局发布《关于银行业保险业人工智能(885728)安全开发应用的指导意见》,共32项,其中专设“提升数据治理能力”一章:建数据资产地图、强化元数据管理、确保源头可追溯,针对业务场景推进高质量数据集和知识工程建设,稳妥探索金融智能体;高风险应用关键环节要人工监督干预,原始数据、推理路径及阈值触发记录要留全。落到行里,绕不开的还是一个个字段。
智能体这一侧更直接:同一个指标换个问法,答案就对不上,一线不敢拿去决策,智能体也就停在查资料、写材料,进不了信贷、风控的流程。缺的不是模型能力,是它取数时认不认得字段背后的业务定义。
三道坎,靠人守不住
标准动辄几千上万项,落到系统却挂不上:标准里的“客户编号”指客户本人,信贷系统同一字段取的却是授信号,业务定义差着一层,字面比不出该挂哪条。字段这边,dkye、kh_rs 这类拼音暗码没有注释,业务含义只在前端标签和老同事的经验里,标准和字段没有可比的语义;治理平台建了、资产目录也有了,业务用数仍要找人问、导表核。智能体给出的结论也没人敢直接采信,出了错谁担责说不清。标准对不上、字段读不懂、责任落不下来,三道坎都压在人身上。
普元把三道坎拆成三步,做进金融数据治理智能体:先建所在银行自己的数据标准,再基于高质量元数据扫全行、梳理全行级码值并识别标准差异,最后自动形成落标建议清单和逐字段落标建议交人终审。三步都记在同一本账上。
第一步 建所在银行自己的数据标准
照搬通用模板,过不了第一道坎。普元在服务10000多家客户、覆盖超过50%的世界500强中国企业的过程中反复看到,业务定义是各家系统自己长出来的。普元金融数据治理智能体从运行中的系统采集高质量元数据,把菜单、表单标签、枚举和字段取值一次采全,自底向上归纳,结合行内词根与监管规范推荐贴合本行的标准初稿,交标准岗仲裁定稿,形成的就是本行自己的数据标准;全行目录可以从三到六个月缩到一到两周。
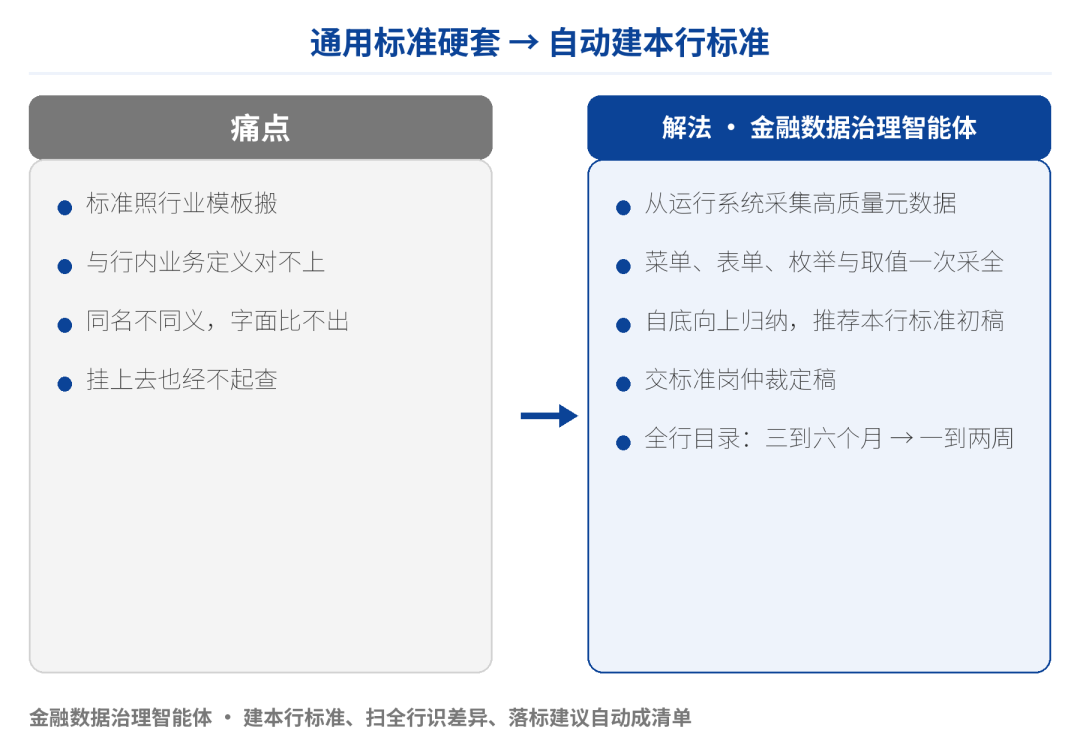
图2 通用模板硬套 vs 元数据建本行标准
第二步 扫全行,识别标准差异与未落标字段
普元金融数据治理智能体基于这套高质量元数据扫全行:为暗码字段补业务释义,把全行各系统的取值、码值、枚举梳理成全行级码值地图,标准与字段才有可比的语义。差异识别不靠字面,看字段绑哪张表单、参与哪条流程,再拿标准定义判定它指哪类实体;标准与业务定义对不上、码值不一致的逐条挑出,哪些没落标、哪些落得存疑,自动筛成清单。新系统接进来重扫一遍,账不断;智能体问到同一个客户,取到的是同一套口径。
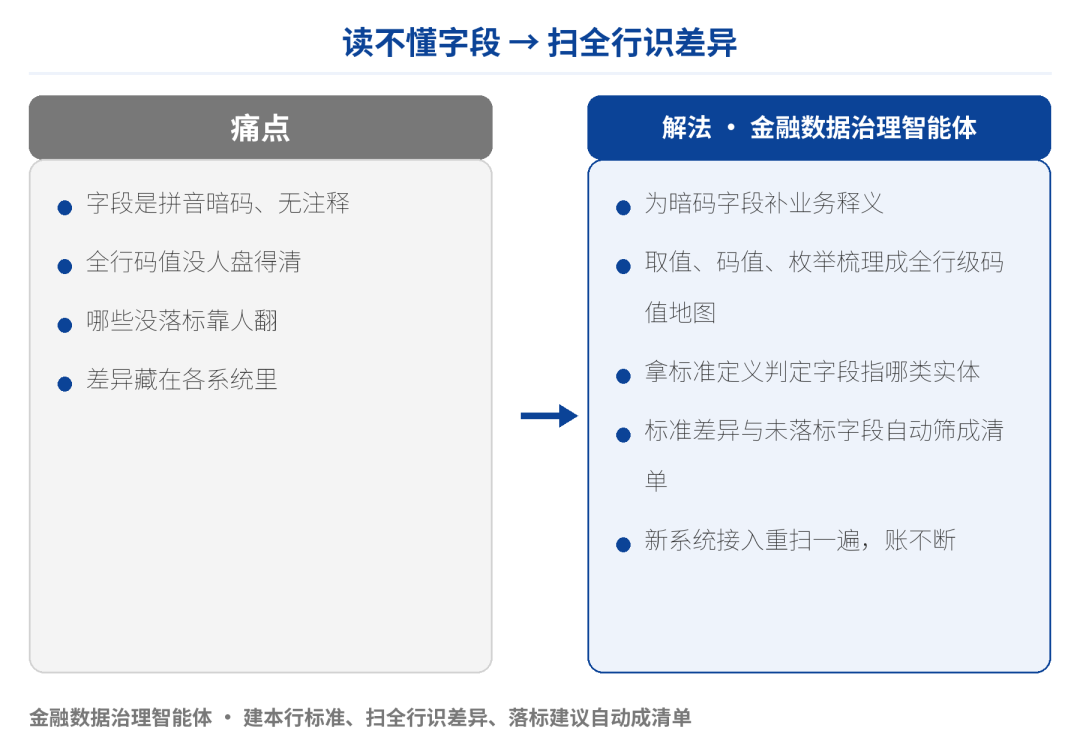
图3 暗码字段靠人翻 vs 扫描自动筛未落标
第三步 落标建议成清单,人做终审
普元金融数据治理智能体为每个待落标字段自动生成一条落标建议:挂哪条标准、依据哪条业务释义和血缘证据,汇总成落标建议清单,按置信度分级。每条都以审批单呈现,接受或驳回,谁在什么时候点的,账上记着。模型只给建议,不落库,终审权始终在人;落不上的字段不勉强挂标,清单上写明原因。
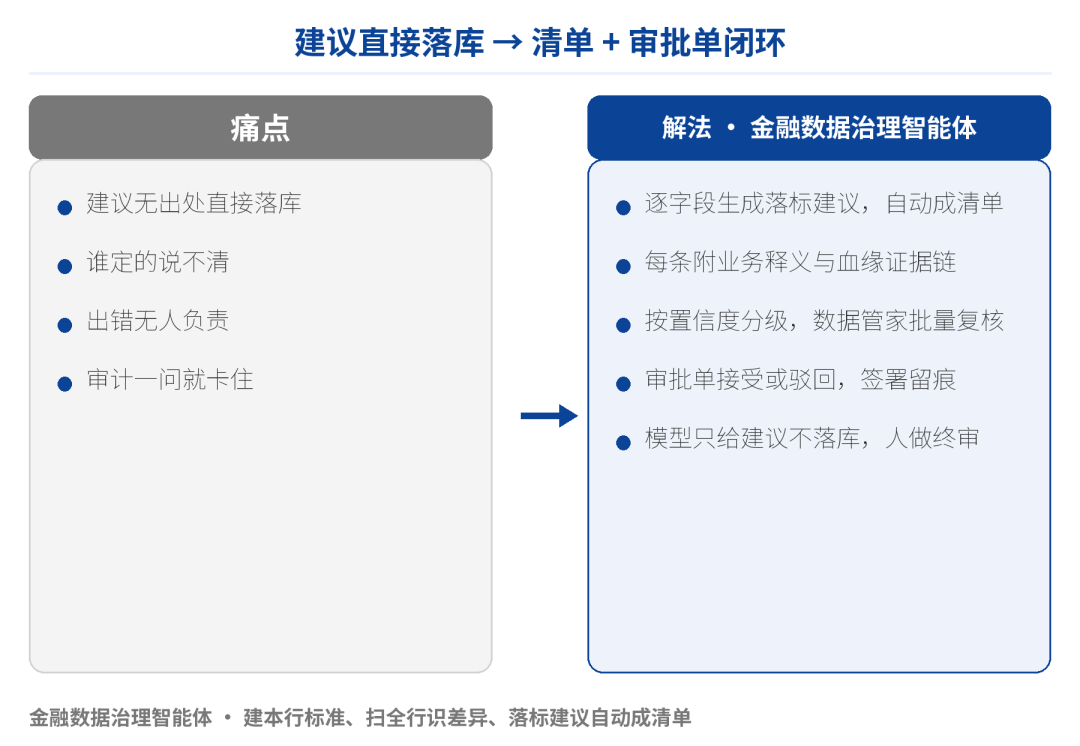
图4 建议直接落库 vs 清单附证据、审批留痕
这套做法已在众多实践中落地,以某家全国性大型股份制银行(884250)为例,300余个自研与外采异构系统、8,000余项企业级数据元标准,标准实际落地率由停滞的60%提升至93%,全行数据质量月报由耗时数周的手工拼凑转为系统自动生成;每条落标建议都附血缘证据链,经数据管家复核签署后才入库。
拿走即用:标准落地三数自查
标准岗对着自家系统就能算,卡在哪一格,就是下一步要补的地方。
三个数 · 怎么算 | 算不出来,缺哪一层 |
|---|---|
| 本行标准占比: 在用数据元标准中,由行内元数据归纳而来的条数占比 | 占比低,说明标准多搬自通用模板,落标源头就对不上本行的业务定义 |
| 未落标字段数: 全行字段总数减去已挂标字段数,并要求能逐条列出清单 | 列不出清单,说明缺一层字段与标准可比的语义底账,只能靠人翻表 |
| 落标建议覆盖率: 已自动生成落标建议的字段数除以未落标字段数 | 有了比例还要看两条:建议是否按置信度分级,每条是否走审批单留痕 |
标准岗要答的,是一句经得起查的话:这个字段,按这条标准,谁定的,什么时候定的。
监管和大模型两头要的,都落在同一套天天在跑的流程里:新系统能重扫、留痕能查、月报自动生成。系统在变、人在换,靠流程,不靠专项。

图5 口径一致后,报送和智能体共用一本账
作为领先的AI原生数字基座提供商,普元更在意帮银行把标准、字段和建议记进同一本账:监管来问、智能体来取数,用的是同一套说法。
这本账,还能往下接什么
同一套元数据底账还能接敏感数据探查、质量检核、血缘下钻。下一套系统上线、下一轮报送,用的还是这本账;每一步怎么做,《金融数据治理智能体白皮书》里列得明白。


